 유튜브·숏폼
AI 목소리가 낱말을 틀리게 읽을 때 쓰는 발음 고침표
TTS가 겹받침과 고유명사를 틀리게 읽을 때, 자막은 그대로 두고 목소리에만 바른 소리를 보내는 표를 만드는 법이에요.
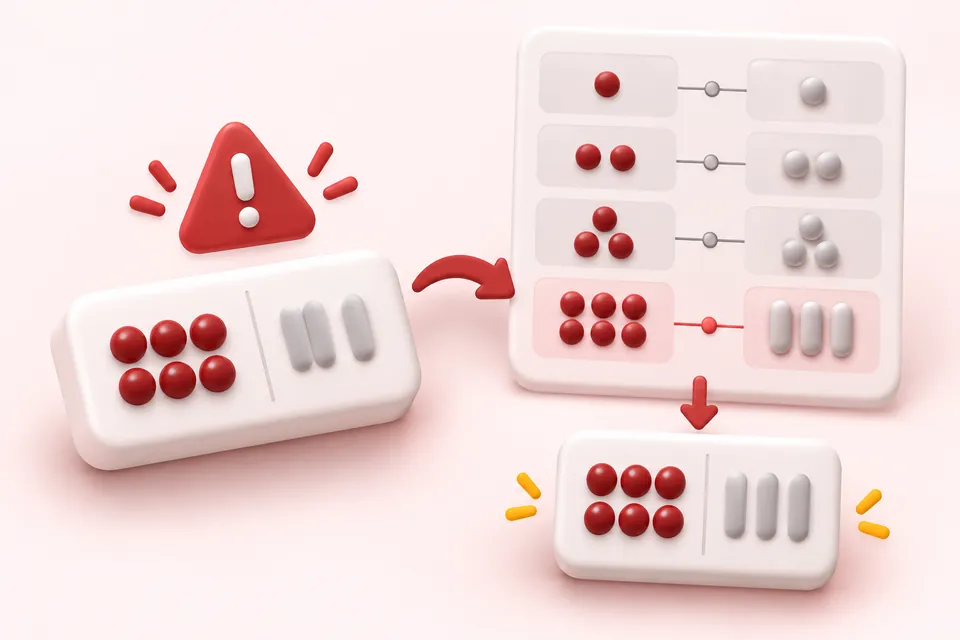
1단계부터 보기 · 모두 11단계틀리게 읽힌 낱말을 «대본 표기 / 소리 나는 대로» 두 칸 표에 모아 두고 TTS에 보내기 직전에만 바꾸면, 자막은 맞춤법대로 남고 목소리는 바르게 나와요.
준비물
- 도구쓰고 있는 TTS, 표 파일 하나(엑셀이나 tsv), 목소리를 다시 들려 줄 AI(이 사례는 Gemini)
- 돈표는 무료예요. 다시 듣기 검사에 AI 사용량 요금이 조금 들어요.
- 걸리는 시간표를 처음 만드는 데 한 시간 안쪽이에요. 이후로는 틀린 낱말이 나올 때마다 한 줄씩 더해요.
- 난이도입문
차례
한 화면에 한 단계씩 넘기며 보세요.
한 쪽에 모두 보기
AI 목소리로 영상 나레이션을 만들다 보면 이상하게 읽는 낱말이 꼭 나와요. 역사 다큐 5편을 만들던 날, 운영자가 시안을 듣고 이렇게 적었어요. «굶어야를 굼어야 라고하고 무서운을 무사운 이라고하네».
TTS가 매번 같은 낱말을 틀리게 읽는다면 대본을 고치기보다 발음 고침표를 하나 두는 편이 나아요. 자막에는 맞춤법대로 «굶어야»가 나오고, 목소리에는 «굴머야»라는 소리가 들어가게 하는 표예요.
먼저 볼 것
쓰고 있는 TTS가 발음을 직접 지정하는 기능을 주는지부터 확인하세요. 구글 Cloud TTS는 SSML의 <phoneme> 태그로 낱말의 소리를 정해 줄 수 있어요. 다만 공식 문서는 발음 지정 기능을 영어부터 지원한다고 적고 있어서, 한국어 Gemini 목소리에서도 되는지는 확인하지 못했어요.
Qwen3-TTS처럼 말투와 감정만 글로 지시하고 소리를 직접 정하는 기능이 없는 엔진도 있어요. 이럴 때는 고침표가 가장 손이 덜 가요.
고침표 만드는 법
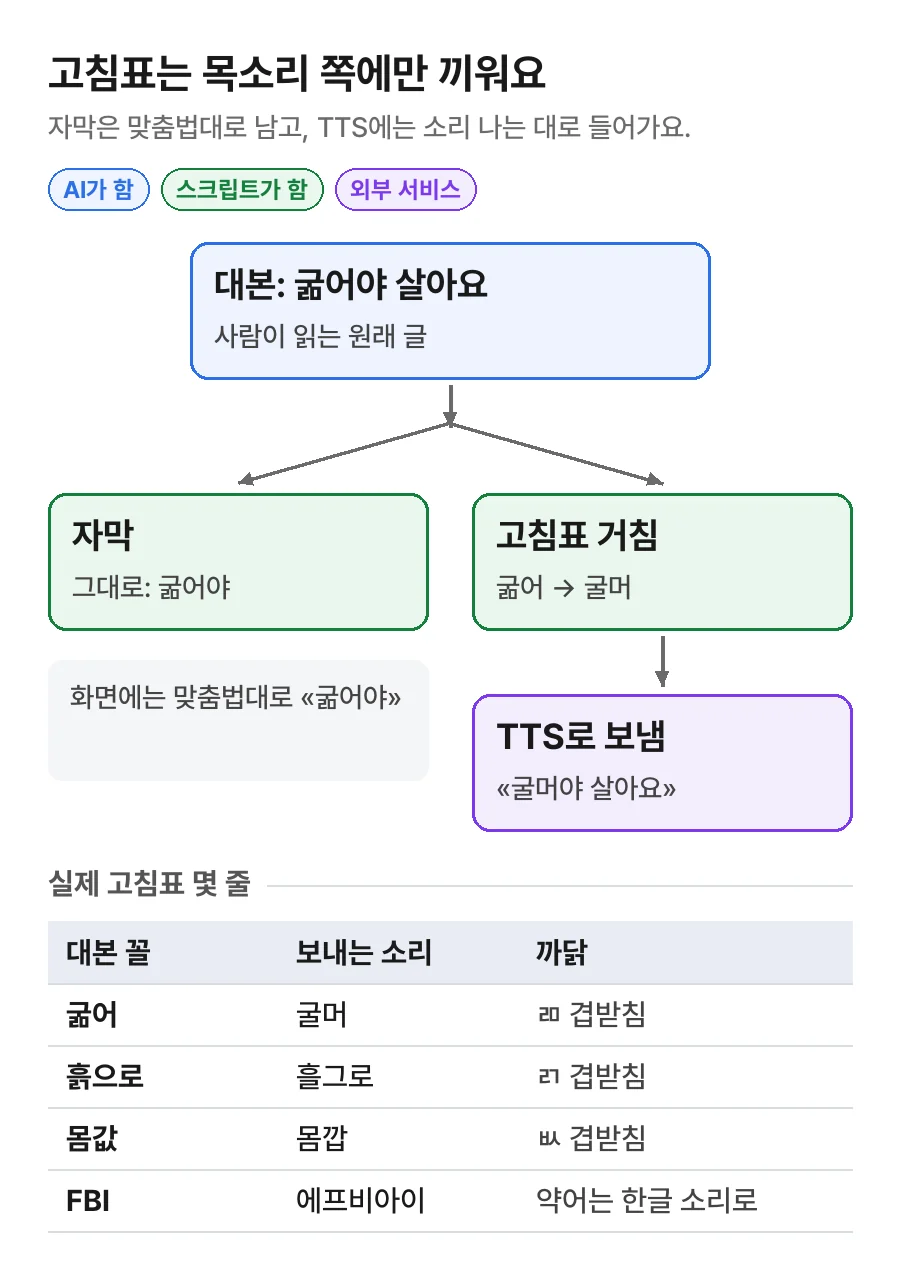
- 칸이 세 개인 표를 만들어요. 대본에 쓴 꼴, 실제로 보낼 소리, 언제 왜 넣었는지를 적어요.
- TTS에 글을 보내기 바로 앞에서만 표대로 바꾸게 해요. 자막과 화면 글자는 대본 그대로 두어야 맞춤법이 지켜져요.
- 같은 꼴은 한꺼번에 넣어요. «굶어»가 틀렸다면 같은 겹받침(ㄻ)이 들어간 «굶주», «젊은»도 함께 넣는 식이에요.
- 표준 발음대로 바뀌는 소리는 고치지 않아요. «범람»이 [범남]으로 들리는 것은 맞는 발음이에요.
- 숫자 읽기는 따로 표를 둬요. 단위에 따라 «여든 곳»과 «팔십 년»처럼 읽는 법이 갈리니까요.
실제로 쓰는 표의 일부예요.
| 대본 꼴 | 보내는 소리 | 넣은 까닭 |
|---|---|---|
| 굶어 | 굴머 | ㄻ 겹받침을 흐리게 읽음 |
| 흙으로 | 흘그로 | ㄺ 겹받침, 다시 듣기에서 «흐그로»로 들림 |
| 몸값 | 몸깝 | ㅄ 겹받침, 같은 꼴을 미리 넣음 |
| 캐서린 | 캐써린 | 세 번 다시 들어 세 번 다 다르게 들림 |
| FBI | 에프비아이 | 약어는 한글 소리로 보냄. 자막은 FBI 그대로 |
틀렸는지 확인하는 법
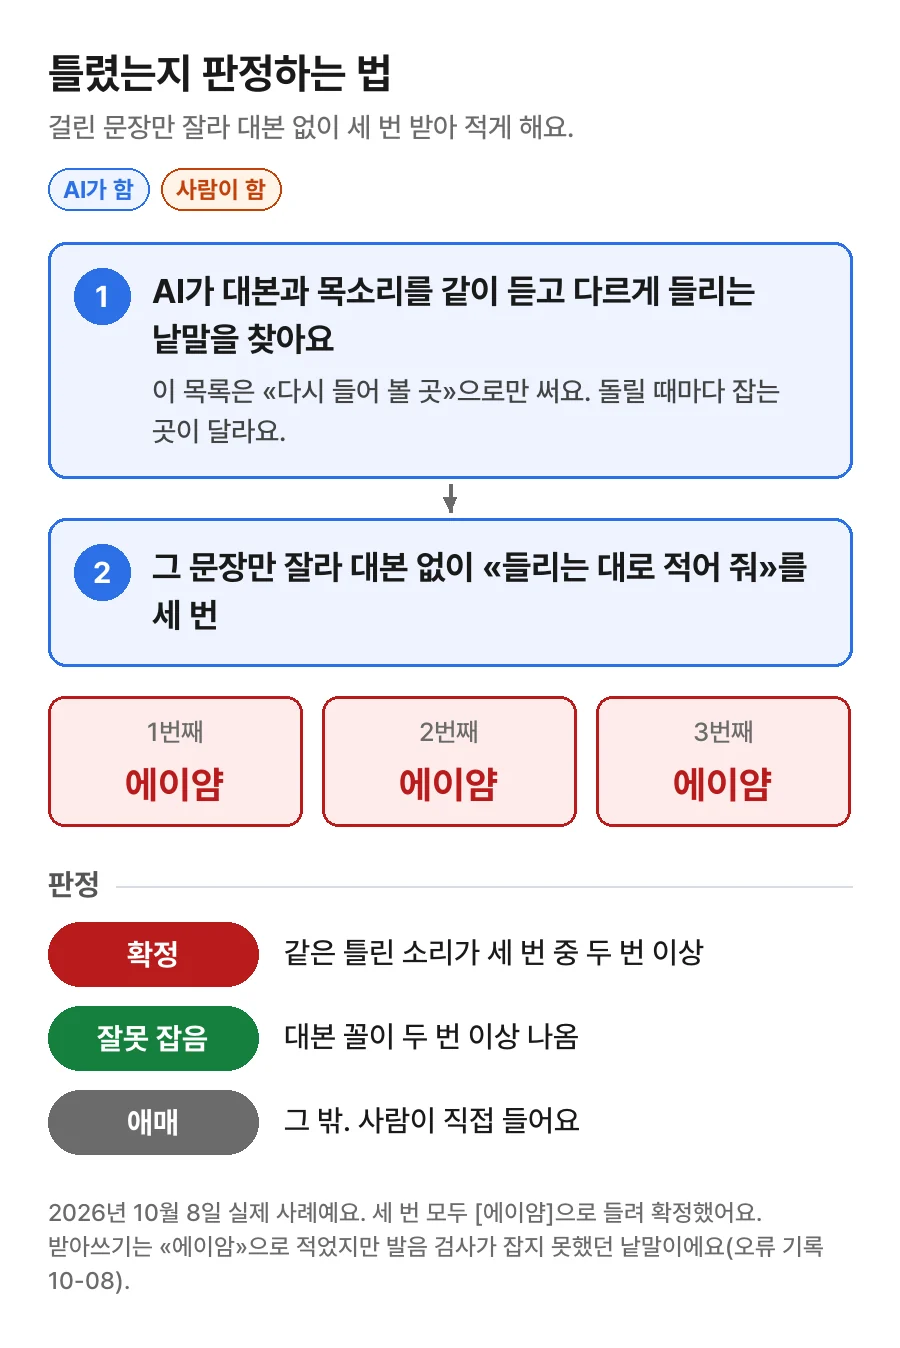
받아쓰기 검사만 믿으면 놓쳐요. 받아쓰기 AI는 들은 소리를 사전에 있는 낱말로 고쳐 적는 버릇이 있어서, 흐리게 읽어도 «맞음»으로 넘어가곤 하거든요.
그래서 두 번 걸러요.
- 목소리 파일과 대본을 함께 AI에게 주고, 대본과 다르게 들리는 낱말을 찾게 해요. 이 목록은 «다시 들어 볼 곳»으로만 써요. 돌릴 때마다 잡는 곳이 달랐거든요.
- 걸린 문장만 잘라서 대본 없이 «들리는 그대로 한글로 적어 달라»고 세 번 시켜요. 세 번 가운데 두 번 이상 같은 틀린 소리가 나오면 확정이고, 대본 꼴이 두 번 이상 나오면 잘못 잡은 것으로 봐요.
확정된 것만 고침표에 넣어요. 잘못 잡은 것까지 다시 만들면 멀쩡하던 문장에서 새 실수가 생기더라고요.
막혔던 곳
겹받침을 줄줄이 흐리게 읽었어요
10월 2일 5편 시안에서 «굶어야», «흙으로», «붉은»이 한꺼번에 흐리게 들렸어요. 낱말 하나씩 고치다가 겹받침 ㄻ·ㄼ·ㄺ·ㅄ이 문제라는 것을 알고, 같은 꼴의 낱말을 미리 모아 넣었어요. 목소리 지시문 끝에도 받침과 겹받침을 표준 발음대로 읽으라는 문장을 한 줄 더했어요.
«여든 곳»을 «팔십 곳»으로 읽었어요
10월 3일 7편에서 생긴 일이에요. 운영자는 예시 하나로 규칙을 넓게 잡으면 다른 데까지 번질까 걱정했어요. «여든 곳 , 마흔 다섯곳 이게 지금은필요한데 이렇게 말하면 안써야 할곳에도 써야할까봐 걱정이야».
그래서 단위어 표를 따로 만들었어요. «곳·명·마리»처럼 고유어로 읽는 단위가 붙은 1~99만 고유어로 읽히고, 날짜와 금액은 한자어로 읽혀요. 뜻이 둘인 단위(장·대·시)는 표에 넣지 않고 대본에 한글로 직접 써요.
받아쓰기 검사를 통과한 이름이 틀리게 들렸어요
10월 8일 쇼츠에 나온 이름 «에얌»을 목소리가 [에이얌]으로 읽었어요. 받아쓰기는 «에이암»으로 적었는데, 발음 검사는 이걸 문제로 잡지 못했어요. 표기를 여덟 가지로 바꿔 각각 세 번씩 들어 본 끝에, «에암»으로 보내야 [에얌]에 가깝게 읽힌다는 것을 찾았어요. 지금은 고유명사가 나오면 받아쓰기 전문을 눈으로 훑어 이름 표기가 다르면 바로 다시 들어요.
근거
- 구글 Cloud Text-to-Speech, SSML 문서 · 2026-10-10 확인.
<phoneme>태그와 발음 지정 기능의 지원 언어가 적혀 있어요. - Qwen3-TTS 공식 저장소 · 2026-10-10 확인. 소리를 직접 지정하는 기능은 문서에서 찾지 못했어요.
이 글을 만든 방법
- 바탕운영자가 실제로 돌린 작업의 기록(작업 일지·설정 파일·오류 기록)
- 쓴 쪽AI(Claude)가 썼어요
- 독립 검수2026-10-10에 쓴 AI와 다른 AI가 원본과 대조해 통과시켰어요
- 사실 확인2026-10-10
- 고친 기록
- 2026-10-10 «받아쓰기 검사는 97% 일치로 통과»를 오류 기록대로 고쳤어요. 받아쓰기는 이 이름을 «에이암»으로 적었고, 발음 검사가 잡지 못했어요. 97%는 다른 규칙의 통과 기준값이었어요. 그림 설명도 같이 고쳤어요.
발행 2026-10-10