 네이버 블로그
 검색어, 데이터랩으로 재 보니 거꾸로 쓰고 있었어요
안경원 블로그가 쓰던 지역 검색어를 네이버 데이터랩으로 재 봤더니, 가장 많이 찾는 말은 적게, 거의 안 찾는 말은 많이 쓰고 있었어요.
1단계부터 보기 · 모두 10단계블로그에 넣을 검색어는 네이버 데이터랩 검색어 트렌드로 후보를 나란히 재 보고 고르세요. «원» 한 글자로 100배가 갈렸어요. 고른 뒤에는 글마다 몇 번 썼는지 검사 스크립트로 세어 배분이 뒤집히지 않게 해요.
준비물
- 도구네이버 데이터랩 검색어 트렌드(웹 화면 또는 개발자 API)
- 돈무료예요.
- 계정웹 화면은 계정 없이 볼 수 있어요. API는 네이버 개발자 애플리케이션 등록이 필요해요.
- 걸리는 시간후보 검색어 열 개 남짓을 한 번 재는 데 길지 않아요.
- 난이도입문
차례
한 화면에 한 단계씩 넘기며 보세요.
한 쪽에 모두 보기
운영자의 안경원 블로그는 AI가 원고를 쓰고 사람이 네이버에 붙여 넣어요. 원고와 네이버 플레이스에 쓰던 지역 검색어는 매장이 있는 동네와 관공서 이름, «안경원» 같은 말을 넣은 조합이었어요.
2026년 8월 1일 운영자가 검색어를 다시 정하라고 했어요(지역·브랜드 이름은 가렸어요).
«네이버에서 [도시] 안경 관련 검색이 가장 많은 것 2개 + [취급 브랜드]를 SEO 주요 키워드로.»
AI는 네이버 데이터랩 검색어 트렌드로 후보를 나란히 쟀어요. 규칙 문서에는 «추측이 아니라 실측값이다»라고 적었어요.
데이터랩은 상대값만 줘요
데이터랩은 검색량을 숫자 그대로 주지 않아요. 네이버 개발자 문서의 설명이에요.
구간별 검색량의 상대적 비율. 구간별 결과에서 가장 큰 값을 100으로 설정한 상댓값입니다.
그래서 기준 검색어 하나를 정해 두고 나머지를 견줘요. 이 블로그는 «[도시] 안경»을 1.00으로 두고 12개월(2025년 8월~2026년 7월) 월간 값을 비교했어요.
| 검색어 꼴 | 상대값 |
|---|---|
| 취급 브랜드 이름 | 77.7 |
| 도시 + 안경점 | 1.04 |
| 도시 + 안경 | 1.00 |
| 도시 + 시 + 안경 | 0.24 |
| 매장 있는 동 + 안경 | 0.18 |
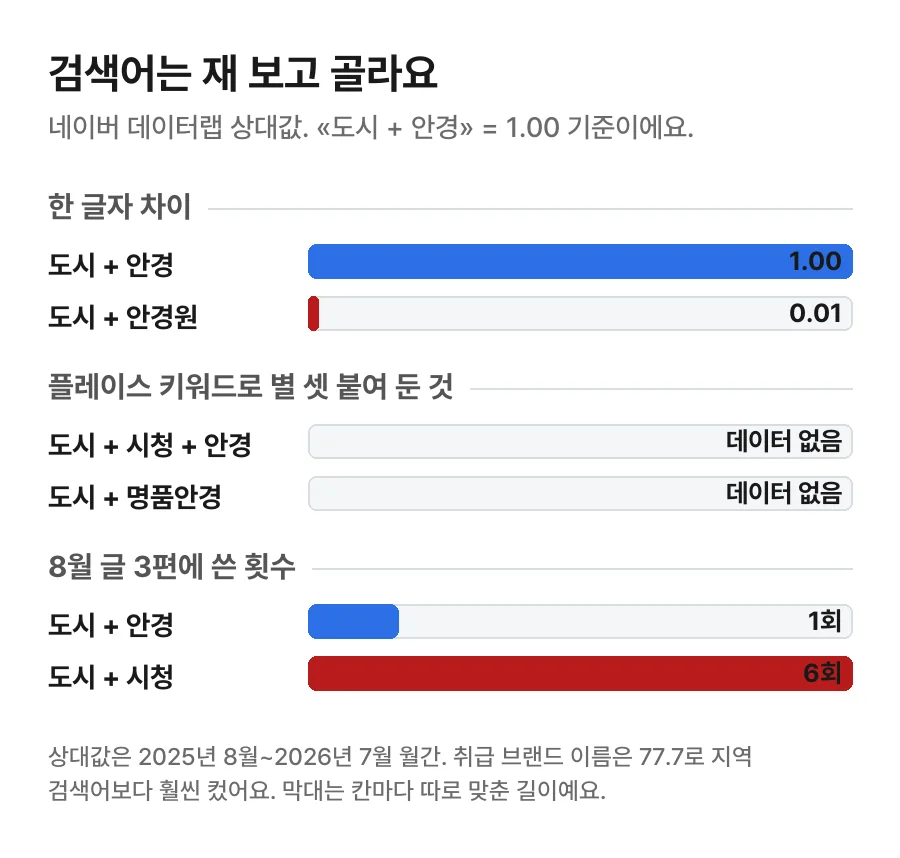
| 도시 + 안경원 | 0.01 |
| 도시 + 시청 + 안경, 도시 + 명품안경 | 데이터 없음 |
거꾸로였던 것
- «원» 한 글자로 100배. «도시 + 안경»은 1.00, «도시 + 안경원»은 0.01이었어요.
- 별 셋을 단 검색어가 비어 있었어요. 네이버 플레이스 키워드 목록에 별 세 개를 붙여 둔 «도시 안경원», «도시 시청 안경원», «도시 명품안경»은 셋 다 검색이 거의 또는 전혀 없었어요.
- 원고 배분도 반대였어요. 8월 3일 운영자가 «다른 건 몰라도 지금 [도시]안경, [동]안경원 이 두 개는 확실하게 키워드 노출되게끔 SEO·GEO·AEO 방향을 잡아줘.»라고 해서 6개월 값을 다시 재고 이미 올린 8월 글 3편을 세어 봤어요. 가장 큰 «도시 + 안경»은 1회, 데이터가 잡히지 않는 «도시 + 시청»은 6회 쓰고 있었어요.
고친 순서
- 기준 검색어 하나를 정해요. 이 블로그는 «도시 + 안경»이에요. 다음에 다시 잴 때도 같은 기준을 써야 회차끼리 비교가 돼요.
- 후보를 한꺼번에 넣어 상대값을 재요. 띄어쓰기와 «점·원» 같은 한 글자 차이도 따로 넣어요.
- 검색어를 성격으로 나눠요. 이 블로그는 «도시 + 안경»을 검색은 많고 경쟁이 심한 말로, «동 + 안경원»을 검색은 작지만 경쟁 글이 거의 없는 말로 보고 쓰는 횟수를 달리 정했어요(글마다 3~5회, 1~2회).
- 원고 검사 스크립트에 횟수 경고를 넣어요. 이 블로그는 «동 + 안경원»이 0회면 경고, «시청»이 3회를 넘으면 경고가 뜨게 했고, 이미 올린 3편에서 실제로 경고가 뜨는 것까지 확인했어요.
- 분기마다 한 번 같은 기준으로 다시 재요.
막혔던 곳
숫자는 상대값뿐이에요
데이터랩은 가장 큰 값을 100으로 바꾼 비율만 줘요. 한 달에 몇 번 검색됐는지는 알 수 없어요. 그래서 «어느 쪽이 큰가»를 정하는 데만 쓰고, 검색량을 추정하지는 않았어요.
너무 작으면 «데이터 없음»으로 나와요
«동 + 안경원»은 6개월 내내 데이터가 잡히지 않았어요. 규칙 문서는 이것을 «공개 기준 아래»로 적었고, 이 말을 «검색은 작지만 경쟁 글도 없는 말»로 보고 버리지 않았어요.
확인하지 못한 것
- 배분을 바꾼 뒤 이 검색어들로 블로그 노출이나 방문이 늘었는지. 그 뒤 성과를 잰 기록은 찾지 못했어요.
- 규칙 문서에 적힌 다시 재는 명령(
datalab_search)의 실제 도구
근거
- 네이버 개발자, 데이터랩 검색어트렌드 API · 2026-10-10 확인. 상대 비율과 «가장 큰 값을 100으로» 설명.
- 운영자의 안경원 블로그 저장소 · 2026-10-10 열어 확인. 발행 가이드 16절(8월 1일 데이터랩 실측 표, 운영자 말)·20절(8월 3일 운영자 말, 6개월 값, 8월 글 3편 1회·6회), 8월 1일·8월 4일 커밋(검사 스크립트 경고 추가와 기존 3편 확인).
이 글을 만든 방법
- 바탕운영자가 실제로 돌린 작업의 기록(작업 일지·설정 파일·오류 기록)
- 쓴 쪽AI(Claude)가 썼어요
- 독립 검수2026-10-10에 쓴 AI와 다른 AI가 원본과 대조해 통과시켰어요
- 사실 확인2026-10-10
발행 2026-10-10